
一个小道具,数据却差了很多。
这条 Reel 显示约 32.3 万次播放, 1 万次点赞,以及 32 条评论,核查于 2026 年 11 月 3 日。
在同一账号公开的 Reels 列表中,另外九条非置顶视频的 播放量中位数为 324。核查时,这条视频显示的总播放量约为 该样本中位数的 1,000 倍填好标签栏。
这是对不同视频年龄的当前累计数据进行的快照比较,不能据此确定差距的原因。
那么,画面里到底发生了什么?
01. 画面把句子补完了。
约 0:01,一只手把白色纸框举在一位厨房员工面前。镂空窗口上方画着一颗心,并写着一行字:
“Our Restaurant is nothing without…”
缺少的结尾,已经在框里了。
约 0:01.1,员工正低头工作;到 0:02.9,她抬头看向镜头,露出笑容。
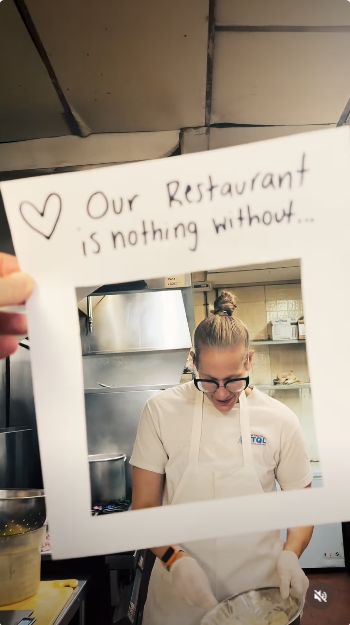
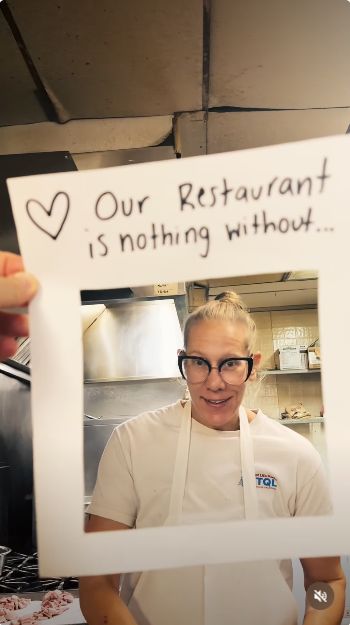
还没等视频多作解释,这句话就得到了一个人的回应。
做自己的版本时,先写一句能由人物、物体或动作直观补完的话,再把答案放进开场镜头。
02. 信息不变,换一个人。
约 0:04.4,纸框围住了炉灶旁一位穿红色上衣、戴深色帽子、面带笑容的员工。
约 0:06,另一位员工出现在前台附近,周围能看到调味品和餐厅标识。
约 0:09.5,又一位员工在墙上时钟下方的炉灶边工作。
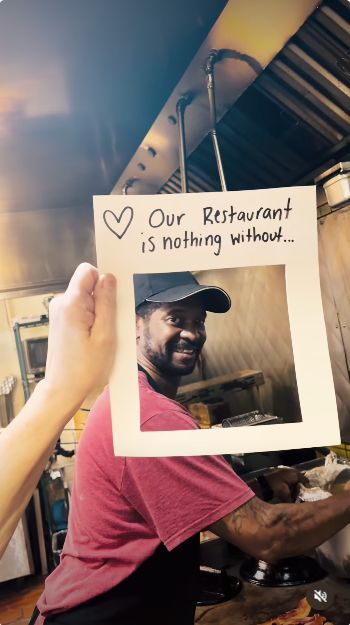
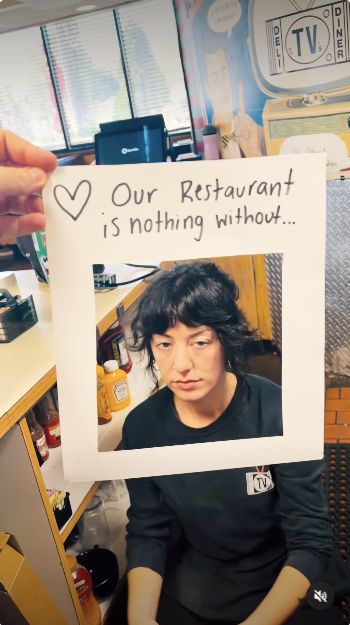
同一句话,不同的人,餐厅里的不同位置。
重复出现的纸框让整段视频有了清晰结构。每位新人物都带来一点新内容,又不用更换标题。
这套结构也能用于工作室、社群或小型商家。保留一个一致的视觉规则,同时不断改变观众在框里发现的内容。
03. 给人物留出回应的时间。
约 0:11.7,一位穿紫色上衣的员工透过镂空窗口微笑挥手。
稍后,约 0:17.8,纸框框住了一位站在收银显示器后、手拿小票的员工。
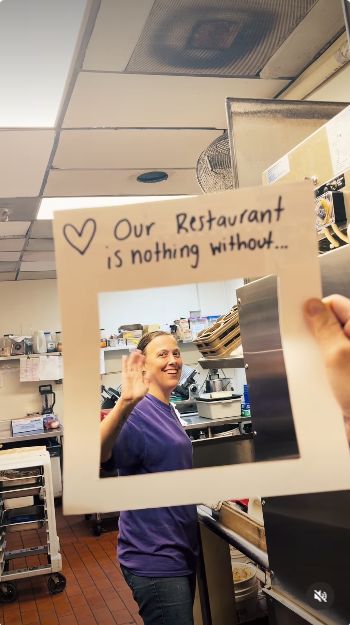
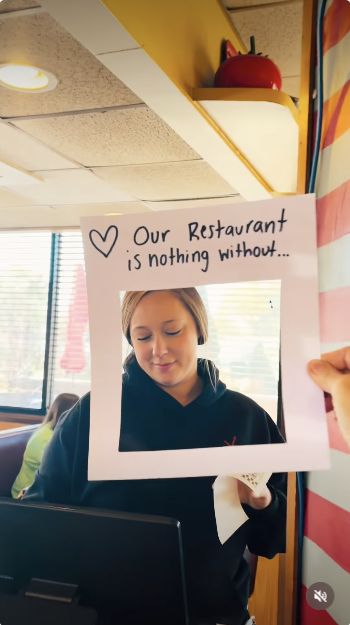
这些细节很小,却让人物各有个性。
纸框周围仍能看到厨房设备、货架、柜台和用餐区。我们看到的是身处工作环境中的人。
手持镜头在不同人物之间移动、倾斜,像有人走遍餐厅,向团队成员逐一致意。
你的版本里,也可以留出一个眼神、一次挥手或一个小动作。给每个人一个具体动作,而不只是站在道具里。
04. 兑现感贯穿整条视频累积起来。
收尾阶段,约 0:20–0:22.5,一位戴帽子和眼镜的员工出现在厨房传菜口后,举起两根手指。
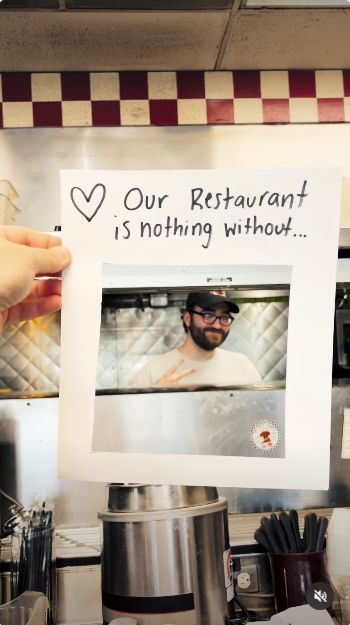
那句手写信息还在。
到这里,我们已经看过好几个人把它补完。一句感谢,变成了一组具体的面孔、反应和工作场景。
这条视频使用纸道具的方式,与 纸板翻牌揭晓 不同。后者通过翻转纸板带出新信息;这里,镂空窗口不断为同一句话呈现新的答案。
结尾的意义,来自前面一组组人物肖像的积累。
把纸框创意变成你自己的。
先想想,你的内容里什么值得被看见和感谢。
面包店可以介绍清晨一批面包背后的员工;社区项目可以展示建成空间背后的志愿者;手作者则能框住最终成为一件作品的材料和工具。
然后选择:
- 一句具体的信息: 能由画面补完的话。
- 一个一致的视觉装置: 相框、开口、形状或前景道具。
- 一组不断变化的画面: 带来新内容的人物、地点或动作。
- 一个收尾画面: 让主题更加明确的镜头。
写自己的句子,设计自己的道具,围绕自己的主题安排镜头。
两段提示词,创作你的版本。
用第一段提示词分析参考视频,再在同一对话中用第二段开发你的原创版本。
查看完整提示词
分析这条参考视频:
https://www.instagram.com/reels/DfC74B9CWLU/

先实际观看视频再分析。不要根据说明、封面、评论或账号类别猜测场景、开头、结尾或剪辑。如果无法播放,说明哪些内容无法核实,并向我索取视频文件。

请按时间点拆解:
1. 开场几秒出现了什么,包括准确的可见文字。
2. 前景纸框与后方人物、工作环境的关系。
3. 人物、地点、动作和构图如何依次变化。
4. 开场创意需要多久才能让人理解,依据已观察画面,不编造留存数据。
5. 收尾镜头兑现了什么,与开场有何关系。
6. 哪些结构思路可以适配其他主题。

区分直接观察与解读。播放时间点是约数时应明确标注,不要写成精确切镜边界。只有实际听到并核实时,才评估音频或踩点关系。

公开数据须附来源、获取时间和显示精度。若能比较同账号视频,列明每条样本、排除项、样本量和计算方式。不要从公开累计数推断留存、销量、转化或因果解释。

最后简要列出可借用的思路,以及原创版本应重新设计的具体元素。
查看完整提示词
基于上面已核实的参考分析,为我开发一条原创短视频。

我的需求:
- 品牌或创作者:[名称]
- 展示主题或对象:[主题]
- 目标受众:[受众]
- 主要目标:[致谢/社群/认知/其他]
- 平台及画幅:[平台;默认 9:16]
- 目标时长:[秒数]
- 场景:[地点或环境]
- 要展示的人、物或动作:[详情]
- 可用视频和图片:[素材或无]
- 品牌语气和视觉风格:[风格]
- 必需的信息或 CTA:[信息]
- 制作限制:[限制]

借用未完成的信息与画面主体补完信息之间的关系。根据我的需求,设计原创标题、道具、镜头序列和结尾。

请提供:
1. 一个清晰概念和开场承诺。
2. 准确的开场文字及后续屏幕文字。
3. 带时间点的分镜,逐镜说明主体、动作、构图、前景道具、背景、转场及预期结果。
4. 兑现开场的收尾镜头。
5. 每个镜头完整、可直接粘贴的视频生成提示词,保持人物、服装、环境、灯光和道具设计一致。
6. 实用组装方案,涵盖镜头顺序、约略时长、文字位置和声音方向。

保持关键信息易读。视觉装置一致,同时变化人物或物体。加入具体反应或动作,不要重复相同姿势。

合适时使用我提供的素材。如果必须生成人物,请创作虚构角色。准确文字应放在可编辑叠字中,或使用已核实可读的道具文字。

如果本次会话有视频生成工具,请生成拟定镜头,并在支持时组装预览;否则交付完整分镜和生成提示词,明确哪些内容尚待制作。只有确有可播放结果时,才声称视频已生成。
来源与时间点
来源:@tvsdeli 的原始 Reel 和 该账号公开的 Reels 列表,核查于 2026 年 11 月 3 日 10:24(UTC+8)。
界面将播放量和点赞数以约数显示为 32.3 万和 1 万,另显示 32 条评论。
比较使用公开列表中可见的 12 条 Reel,排除两条置顶和目标视频。其余九条的播放量分别为 156、183、185、410、347、324、424、5,456 和 116,中位数为 324;约 323,000 ÷ 324,得到约 997 倍的快照比值。
视频约 24 秒。时间点对应浏览器播放时核对过的画面,不是精确切镜边界。本拆解覆盖可见画面和文字,未评估音频。