
一個小道具,數據卻差了很多。
這條 Reel 顯示約 32.3 萬次觀看, 1 萬個讚,以及 32 則留言,查核於 2026 年 11 月 3 日。
在同一帳號公開的 Reels 列表中,另外九條非置頂影片的 觀看次數中位數為 324。查核時,這條影片顯示的總觀看次數約為 該樣本中位數的 1,000 倍填好標記欄位。
這是對不同影片年齡的當前累計數據進行的快照比較,無法據此確定差距原因。
那麼,畫面裡到底發生了什麼?
01. 畫面把句子補完了。
約 0:01,一隻手把白色紙框舉在一位廚房員工面前。鏤空窗口上方畫著一顆心,並寫著一行字:
“Our Restaurant is nothing without…”
缺少的結尾,已經在框裡了。
約 0:01.1,員工正低頭工作;到了 0:02.9,她抬頭看向鏡頭,露出笑容。
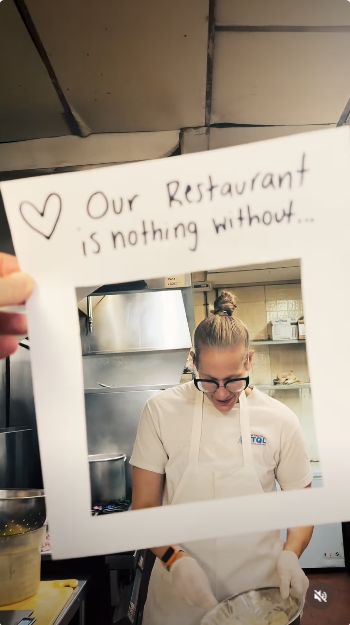
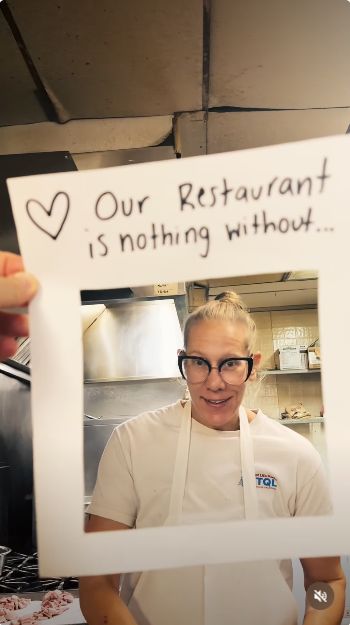
還沒等影片多作解釋,這句話就得到了一個人的回應。
做自己的版本時,先寫一句能由人物、物體或動作直觀補完的話,再把答案放進開場鏡頭。
02. 訊息不變,換一個人。
約 0:04.4,紙框圍住了爐灶旁一位穿紅色上衣、戴深色帽子、面帶笑容的員工。
約 0:06,另一位員工出現在櫃檯附近,周圍能看到調味品和餐廳標誌。
約 0:09.5,又一位員工在牆上時鐘下方的爐灶邊工作。
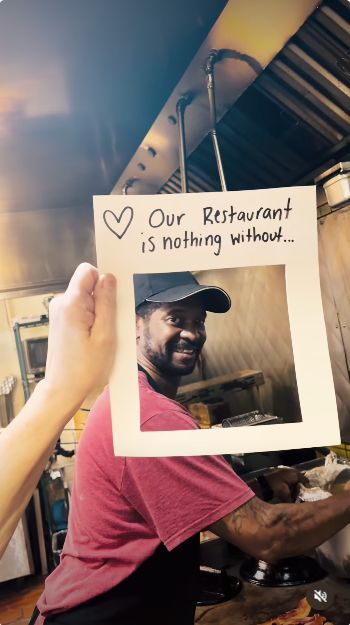
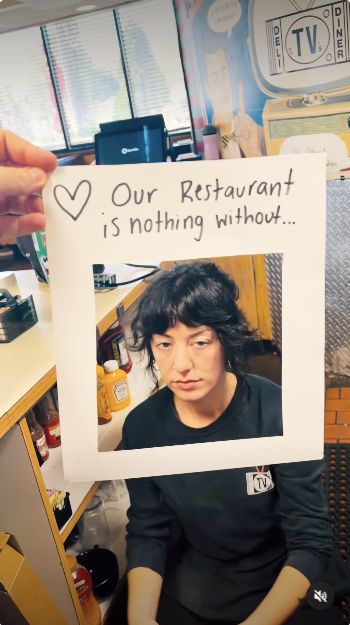
同一句話,不同的人,餐廳裡的不同位置。
重複出現的紙框讓整段影片有了清楚結構。每位新人物都帶來一點新內容,又不用更換標題。
這套結構也能用於工作室、社群或小型商家。保留一個一致的視覺規則,同時持續改變觀眾在框裡發現的內容。
03. 給人物留出回應的時間。
約 0:11.7,一位穿紫色上衣的員工透過鏤空窗口微笑揮手。
稍後,約 0:17.8,紙框框住了一位站在收銀螢幕後、手拿收據的員工。
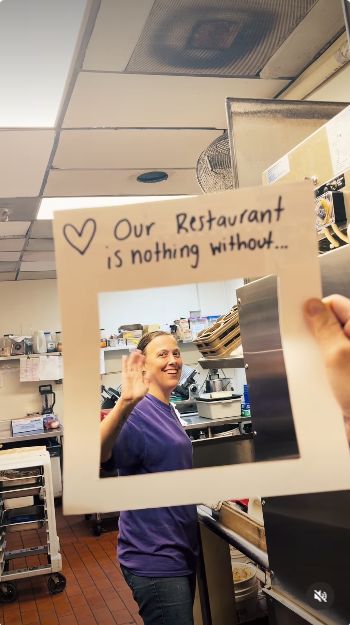
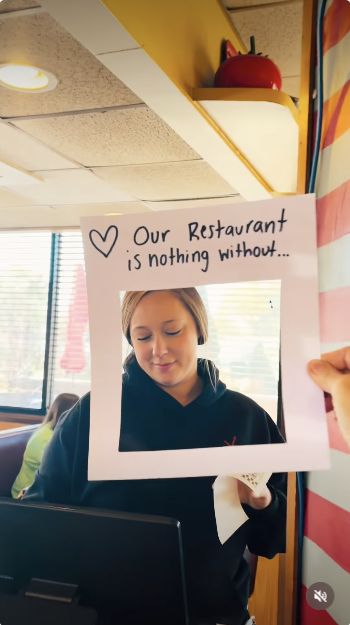
這些細節很小,卻讓人物各有個性。
紙框周圍仍能看到廚房設備、貨架、櫃檯和用餐區。我們看到的是身處工作環境中的人。
手持鏡頭在不同人物之間移動、傾斜,像有人走遍餐廳,向團隊成員逐一致意。
你的版本裡,也可以留出一個眼神、一次揮手或一個小動作。給每個人一個具體動作,而不只是站在道具裡。
04. 兌現感貫穿整條影片累積起來。
收尾階段,約 0:20–0:22.5,一位戴帽子和眼鏡的員工出現在廚房出餐口後,舉起兩根手指。
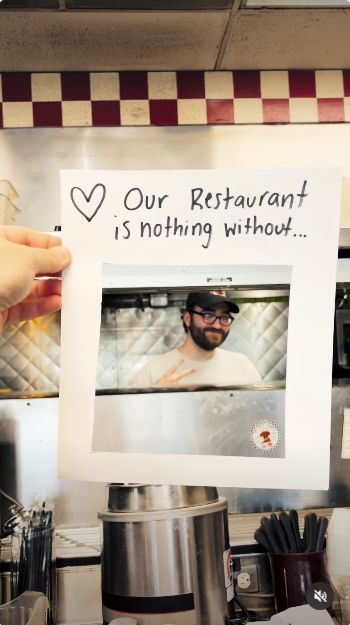
那句手寫訊息還在。
到這裡,我們已經看過好幾個人把它補完。一句感謝,變成了一組具體的面孔、反應和工作場景。
這條影片使用紙道具的方式,與 紙板翻面揭曉 不同。後者透過翻轉紙板帶出新資訊;這裡,鏤空窗口不斷為同一句話呈現新的答案。
結尾的意義,來自前面一組組人物肖像的累積。
把紙框創意變成你自己的。
先想想,你的內容裡什麼值得被看見和感謝。
麵包店可以介紹清晨一批麵包背後的員工;社區計畫可以展示建成空間背後的志工;手作者則能框住最後成為一件作品的材料和工具。
接著選擇:
- 一句具體的訊息: 能由畫面補完的話。
- 一個一致的視覺裝置: 相框、開口、形狀或前景道具。
- 一組持續變化的畫面: 帶來新內容的人物、地點或動作。
- 一個收尾畫面: 讓主題更加明確的鏡頭。
寫自己的句子,設計自己的道具,圍繞自己的主題安排鏡頭。
兩組提示詞,你的原創版本。
用第一段提示詞分析參考影片,再在同一對話中用第二段開發你的原創版本。
檢視完整提示詞
分析這條參考影片:
https://www.instagram.com/reels/DfC74B9CWLU/

先實際觀看影片再分析。不要根據說明、封面、留言或帳號類別猜測場景、開頭、結尾或剪輯。如果無法播放,說明哪些內容無法查核,並向我索取影片檔案。

請依時間點拆解:
1. 開場幾秒出現了什麼,包括準確的可見文字。
2. 前景紙框與後方人物、工作環境的關係。
3. 人物、地點、動作和構圖如何依次變化。
4. 開場創意需要多久才能讓人理解,依據已觀察畫面,不編造留存數據。
5. 收尾鏡頭兌現了什麼,與開場有何關係。
6. 哪些結構思路可以適配其他主題。

區分直接觀察與解讀。播放時間點是約數時應明確標示,不要寫成精確切鏡邊界。只有實際聽到並查核時,才評估音訊或踩點關係。

公開數據須附來源、取得時間和顯示精度。若能比較同帳號影片,列明每條樣本、排除項、樣本數和計算方式。不要從公開累計數推論留存、銷量、轉換或因果解釋。

最後簡要列出可借用的思路,以及原創版本應重新設計的具體元素。
檢視完整提示詞
根據上面已查核的參考分析,為我開發一條原創短影片。

我的需求:
- 品牌或創作者:[名稱]
- 展示主題或對象:[主題]
- 目標受眾:[受眾]
- 主要目標:[致謝/社群/認知/其他]
- 平台及畫幅:[平台;預設 9:16]
- 目標長度:[秒數]
- 場景:[地點或環境]
- 要展示的人、物或動作:[詳情]
- 可用影片和圖片:[素材或無]
- 品牌語氣和視覺風格:[風格]
- 必需的訊息或 CTA:[訊息]
- 製作限制:[限制]

借用未完成的訊息與畫面主體補完訊息之間的關係。依照我的需求,設計原創標題、道具、鏡頭順序和結尾。

請提供:
1. 一個清楚概念和開場承諾。
2. 準確的開場文字及後續螢幕文字。
3. 帶時間點的分鏡,逐鏡說明主體、動作、構圖、前景道具、背景、轉場與預期結果。
4. 兌現開場的收尾鏡頭。
5. 每個鏡頭完整、可直接貼上的影片生成提示詞,保持人物、服裝、環境、燈光和道具設計一致。
6. 實用組裝方案,涵蓋鏡頭順序、約略長度、文字位置和聲音方向。

保持關鍵訊息易讀。視覺裝置一致,同時改變人物或物體。加入具體反應或動作,不要重複相同姿勢。

合適時使用我提供的素材。如果必須生成人物,請創作虛構角色。準確文字應放在可編輯疊字中,或使用已查核可讀的道具文字。

如果本次對話有影片生成工具,請生成擬定鏡頭,並在支援時組裝預覽;否則交付完整分鏡和生成提示詞,明確說明哪些內容尚待製作。只有確有可播放結果時,才聲稱影片已生成。
來源與時間
來源:@tvsdeli 的原始 Reel 和 該帳號公開的 Reels 列表,查核於 2026 年 11 月 3 日 10:24(UTC+8)。
介面將觀看次數和按讚數以約數顯示為 32.3 萬和 1 萬,另顯示 32 則留言。
比較使用公開列表中可見的 12 條 Reel,排除兩條置頂和目標影片。其餘九條的觀看次數分別為 156、183、185、410、347、324、424、5,456 和 116,中位數為 324;約 323,000 ÷ 324,得到約 997 倍的快照比值。
影片約 24 秒。時間點對應瀏覽器播放時核對過的畫面,不是精確切鏡邊界。本拆解涵蓋可見畫面和文字,未評估音訊。