
我们分析了100条AI教程Shorts。创作者如何吸引观众?
通过绘画编辑幻灯片的承诺。AI能否在声音设计上胜过人的问题。让七个模型执行同一任务的一罐糖豆。
创作者如何引出有用任务、开始演示并交付承诺结果。
我们研究了来自30个成熟频道的100条英语AI教程及演示类YouTube Shorts,观察创作者如何开启一条有用的视频。在我们的编码中,最常见的主要模式是直接承诺:100条视频中,有36条直接点明观众可以学会、制作或完成什么。
这些模式描述样本视频的结构。我们没有测量观众留存。
01 · 开场模式
这100条视频样本中的开场模式
钩子是开场时给观众继续观看理由的手法。我们按主要开场手法对每条视频分类,采用下列定义。类别重叠时以目的为先:为测试铺垫的问题归为实验;围绕观众困难的问题归为痛点引导。
| 主要钩子 | 含义 | 视频数 | 占比 |
|---|---|---|---|
| 直接承诺 | 点明观众将学会、制作或完成什么。 | 36 | 36% |
| 痛点引导 | 从观众熟悉的问题开始。 | 17 | 17% |
| 其他 | 使用故事、类比、定义或立即给出指令。 | 15 | 15% |
| 结果先行 | 先展示完成的输出或变化。 | 14 | 14% |
| 挑战或实验 | 设置测试、对比或带限制的任务。 | 11 | 11% |
| 问题或好奇 | 打开需由视频解答的信息缺口。 | 4 | 4% |
| 纠正或警告 | 指出错误或应避免的做法。 | 3 | 3% |
| 反直觉 | 挑战普遍持有的看法。 | 0 | 0% |
**有效样本n=100;缺失主要分类=0。**没有视频以反直觉作为主要标签。
视频数 · n=100 · 缺失=0
- 直接承诺
- 36
- 痛点引导
- 17
- 其他
- 15
- 结果先行
- 14
- 挑战或实验
- 11
- 问题或好奇
- 4
- 纠正或警告
- 3
- 反直觉
- 0
计数刻度:0–50条视频
这些标签描述开场,而非其表现。仅仅延后答案,不足以把视频归为好奇引导。
02 · 100条视频的时间分布
价值何时明确,有用内容又从何时开始
我们对全部100条视频的两个时点编码。价值明确指观众能够识别所解决的问题或所提供的结果。首次实质交付指第一个可执行步骤、具体答案或有意义的任务演示。泛泛预告不计入。具体对比结果或演示输入到输出的变化,即使不是逐步点击教程,也可以计入。
每条视频都有根据字幕与视频证据给出的估计时间区间。较宽区间代表证据较不精确;从零开始的区间表示事件可能已在开场出现。
价值明确时间的中位数落在0–6秒内;首次交付时间的中位数落在7.5–13秒内。我们分别取100个下端点和上端点的中位数来计算边界。它们描述事件发生时间的不确定性,并非建议时限。
每项指标有效样本n=100;缺失区间=0。未测量精确起始时刻。
估计时间区间 · n=100 · 未编码=0
- 区间在10秒内结束
- 82
- 10秒时不确定
- 18
- 区间在10秒后开始
- 0
跨越区间包含10秒之前与之后的时刻。精确起始时刻仍是估计。
估计时间区间 · n=100 · 未编码=0
- 区间在10秒内结束
- 29
- 10秒时不确定
- 41
- 区间在10秒后开始
- 30
跨越区间包含10秒之前与之后的时刻。精确起始时刻仍是估计。
到第十秒,82个价值明确区间及29个首次交付区间已经结束。另有18个价值区间和41个交付区间跨越十秒点:我们无法有把握地判断事件在此之前还是之后发生。30个交付区间在十秒后开始。
具体案例体现了这一区别。Jeff Su在估计0–4秒的区间内介绍AI记忆结果,并在3–8秒区间开始讲内置记忆设置。Andy Stapleton的学术提示片段较早传达主题,但首条文档放置指令落在27–33秒区间。
可在样本库比较两个时点,或下载完整时间表,其中包含事件描述及证据引用。
03 · 九个案例研究
九个值得研究的真实开场
1. 点明具体编辑,再实际完成
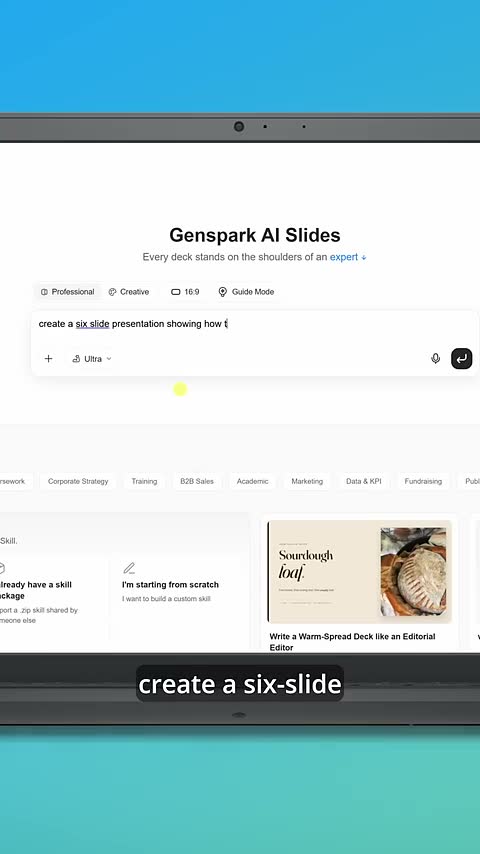
观看原始ShortKevin Stratvert的幻灯片编辑教程把清晰的屏幕标题与直接能力承诺配在一起。任务很具体:创建演示文稿,再通过在幻灯片上绘画来修改它。
正文进入Genspark,请求六页烘焙饼干演示文稿,缩短副标题,并用箭头移动图像。这些操作把开场连到观众能够检查的结果。可复用结构是一个结果、一个工具与一次可见修改,而非抽象地宣称AI节省时间。
2. 把熟悉的负担变成简短路径
观看原始ShortAurelius Tjin的Gamma演示文稿教程以手工制作演示文稿的问题开始。开场标题已经点明期望结果。
片段随后进入工具、提示词、生成演示文稿及简单修改。推荐优惠属于内容的一部分,已记入研究表。可迁移到其他教程的是这个顺序:熟悉的工作、具体替代方案、首个有用步骤、可检查结果。
3. 让编号承诺不超出证据
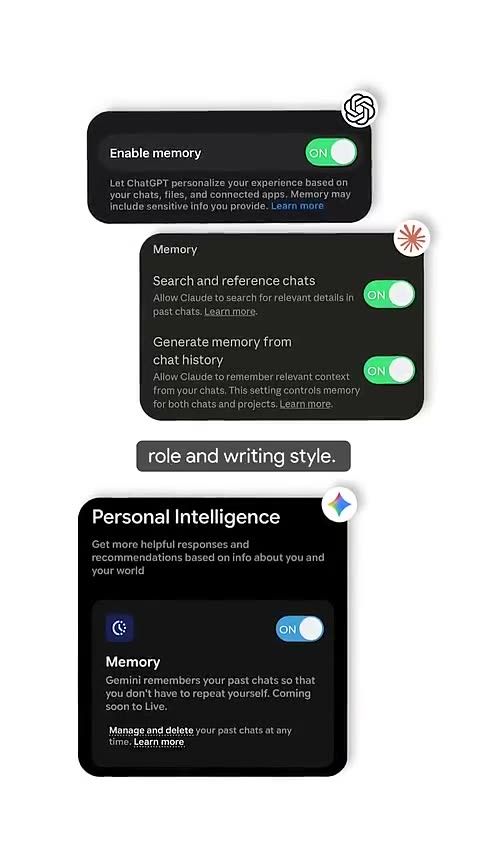
观看原始ShortJeff Su的AI记忆教程围绕三层组织正文:内置记忆、项目及自定义记忆系统。它提供清楚的递进,而非松散技巧列表。
我们把交付标为部分,因为开场的完美记忆、此后无需纠正等范围超出三个示例所能证实。可用的写作经验是保留递进,把承诺收窄到视频能演示的范围。三步结构不需要无限保证。
4. 让对比可听见且范围明确
观看原始ShortCurious Refuge的AI与人类声音设计测试提出正文确实能回应的问题。它采用同一场景,先播放AI版本与人类版本,再给出判断。
我们将其编码为挑战,而非泛泛提问。对比任务提供了结构。判断仍是创作者对这些示例的评价,并不能证明某种方法总能产生更好的声音设计。
5. 给实验一个真实答案
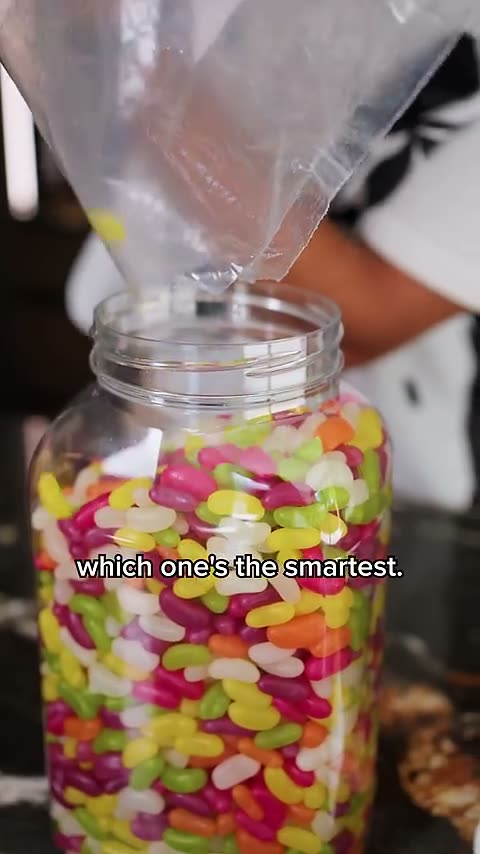
观看原始Short在哪个AI最聪明?中,Mrwhosetheboss用一罐糖豆把模型对比任务变得可见。每个模型都需估数;最后清点数提供真实答案。
结尾回答了开头设定的测试,但没有确立普遍最聪明的模型。改编这个结构时,录制前先决定输入、评分规则与结尾。否则,对比可能变成没有结论的一连串输出。
6. 先展示具体失败,再解释
观看原始ShortAI回答不了的问题先提出一项涉及左手写字者的图像请求,再指出不符。鸡蛋数量与镜中倒影延续这一模式。
这是围绕失败的结果先行结构。具体提示词与可检查错误让解释有所针对。我们的编码关注呈现与兑现承诺,不验证视频对模型内部机制的简化说法。
7. 用修改过程填充故事中段
观看原始ShortNate Herk的Claude编辑演示描述迭代过程:看不清的字幕变成对比度规则,静态素材变成运动要求,同步问题变成检查项。
正文在工作流中为每项改进交代原因:具体反馈成为持久编辑规则。这为讲优化的教程形成可重复结构。展示起初问题,说明改动,再展示作用。发现托管关键帧不一致后,我们对该来源作了交叉核对;有争议的画面未用作时间或视觉证据。
8. 让屏幕承担教学
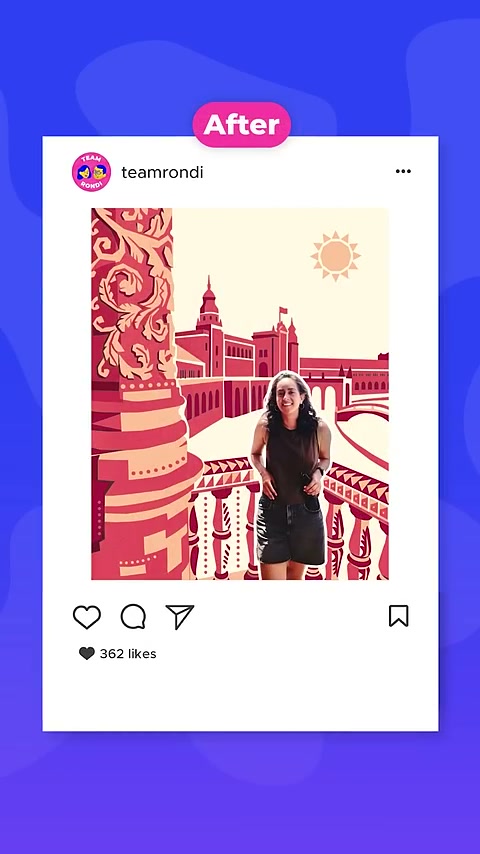
观看原始ShortDesign with Canva的照片改风格演示没有口述开场句。标题与照片变化引出任务,屏幕录像再通过箭头、提示词与界面操作引导观众。
结尾在前后对比的社交模型中展示改风格构图。这个结构不需要口播承诺也能理解:标题点明变化,屏幕提供步骤,结尾回到变化。缺失的口述句按不存在记录,而非从音乐转写重构。
9. 把研究缺口变成第一个行动
观看原始ShortAndy Stapleton的Perplexity引言写作流程从参考文献不足的问题开始。它进入具体研究提示词,展示所得草稿及参考文献,再解释如何把文献用于引用流程。
他明确把输出视为起点,而非直接照抄的文字。可迁移结构是具体缺口、工具操作、可检查输出与范围明确的下一步。本研究不独立验证生成的参考文献,也不把草稿当已完成的学术作品。
完整样本 · 30个贡献频道探索全部100条视频解读+
浏览每条入选视频。标签描述开场与交付;公开播放量是背景,不是钩子有效性的衡量。
查看全部30个贡献频道及样本数
- Jeff Su ↗视频数:5
- Kevin Stratvert ↗视频数:5
- Futurepedia ↗视频数:5
- The AI Advantage ↗视频数:5
- Skill Leap AI ↗视频数:5
- Hayls World ↗视频数:1
- Matt Wolfe ↗视频数:5
- Justin Brown - Primal Video ↗视频数:5
- Think Media ↗视频数:2
- PiXimperfect ↗视频数:2
- Aurelius Tjin ↗视频数:5
- Beebom ↗视频数:2
- Website Learners ↗视频数:5
- Mrwhosetheboss ↗视频数:3
- Theoretically Media ↗视频数:2
- Curious Refuge ↗视频数:4
- Nate Herk | AI Automation ↗视频数:4
- Riley Brown ↗视频数:4
- Sam Beckman ↗视频数:1
- Trakin Tech English ↗视频数:4
- Creator Magic ↗视频数:2
- Tina Huang ↗视频数:4
- The Rundown AI ↗视频数:1
- Olivio Sarikas ↗视频数:1
- Andy Stapleton ↗视频数:4
- corbin ↗视频数:1
- Matthew Berman ↗视频数:4
- Design with Canva ↗视频数:4
- Ali Abdaal ↗视频数:4
- Sebastian Kamph ↗视频数:1
匹配视频:100条 · 显示1–10
01Give your AI perfect memory in 3 stepsJeff Su · 直接承诺+
发布于2026年9月2日(UTC) · 64秒 · 17,610次公开播放
播放快照:2026年10月27日(UTC)
价值明确: 0–4秒 · AI记忆效果
首次有用交付: 3–8秒 · 在点名工具中开启内置记忆
根据字幕与视频证据估计。
可复用结构: 承诺改善记忆 → 内置设置 → 项目 → 自定义记忆
承诺兑现——部分: 提供了三个步骤,但不足以证明记忆完美或永远不需纠正。
观看原始Short ↗02This AI Lets You Edit Presentations by Drawing! 🤯Kevin Stratvert · 直接承诺+
发布于2026年10月26日(UTC) · 57秒 · 3,163次公开播放
播放快照:2026年10月27日(UTC)
价值明确: 0–5秒 · 创建并绘图修改幻灯片
首次有用交付: 4–10秒 · 进入网站并选择AI幻灯片;开头的结果预览不是操作流程
根据字幕与视频证据估计。
可复用结构: 点明输出与修改方式 → 生成演示文稿 → 绘图修改 → 导出
承诺兑现——是: 实际幻灯片生成与绘图修改流程实现了所述能力。
观看原始Short ↗03Claude video generator is a game changerFuturepedia · 直接承诺+
发布于2026年10月24日(UTC) · 75秒 · 3,564次公开播放
播放快照:2026年10月27日(UTC)
价值明确: 0–5秒 · Claude动画及讲解视频
首次有用交付: 8–12秒 · 实际星星动画样例开始,不是开头的承诺
根据字幕与视频证据估计。
可复用结构: 点明新输出 → 展示生成的讲解视频 → 讨论风格选择
承诺兑现——是: 开头介绍一种新输出并承诺示例,主体提供了示例;并未承诺逐次点击的完整制作教程。
观看原始Short ↗04My Favorite Use Case for AI AgentsThe AI Advantage · 直接承诺+
发布于2026年10月23日(UTC) · 59秒 · 2,017次公开播放
播放快照:2026年10月27日(UTC)
价值明确: 5–9秒 · 通过智能体预约
首次有用交付: 15–24秒 · 先将同事与智能体放入Slack聊天,再请求时间段
根据字幕与视频证据估计。
可复用结构: 点明喜欢的任务 → Slack请求 → 日历输出 → 排期规则
承诺兑现——是: 展示了可辨识的预约流程。
观看原始Short ↗05Gemini 4 Just Did Something WildSkill Leap AI · 结果先行+
发布于2026年10月23日(UTC) · 52秒 · 2,053次公开播放
播放快照:2026年10月27日(UTC)
价值明确: 0–6秒 · 漫游生成的古罗马
首次有用交付: 4–11秒 · 提示词与可导航环境的游览
根据字幕与视频证据估计。
可复用结构: 展示生成世界 → 公开提示词 → 浏览输出 → 有限比较
承诺兑现——是: 提供了可复现的任务描述及交互输出。
观看原始Short ↗06iOS 27 - NEW Photo ToolsHayls World · 挑战或实验+
发布于2026年6月11日(UTC) · 67秒 · 325,629次公开播放
播放快照:2026年10月27日(UTC)
价值明确: 0–5秒 · 测试照片编辑工具
首次有用交付: 9–14秒 · 在要移除的对象周围画圈
根据字幕与视频证据估计。
可复用结构: 测试新编辑工具 → 移除对象 → 扩展照片 → 改变视角 → 展示结果
承诺兑现——是: 实操示例完成了开头设定的照片编辑测试;设备可用性与技术实现并未独立核实。
观看原始Short ↗07These ChatGPT Prompts Are Game-Changers!Matt Wolfe · 直接承诺+
发布于2026年10月23日(UTC) · 51秒 · 8,798次公开播放
播放快照:2026年10月27日(UTC)
价值明确: 0–4秒 · 三个智能体提示词
首次有用交付: 10–16秒 · 开始展示降价及退款追踪提示词
根据字幕与视频证据估计。
可复用结构: 承诺三种用途 → 提供三个具体智能体提示词
承诺兑现——是: 提供了三个任务提示词;本分析不对自主执行交易作背书。
观看原始Short ↗08Bad AI Video Edits? Check Your Transcript FirstJustin Brown - Primal Video · 痛点引导+
发布于2026年9月25日(UTC) · 40秒 · 1,809次公开播放
播放快照:2026年10月27日(UTC)
价值明确: 0–4秒 · 转写错误导致AI剪辑出错
首次有用交付: 3–8秒 · 用具体的重复开场白示例解释剪辑错误
根据字幕与视频证据估计。
可复用结构: 剪辑出错问题 → 转写示例 → 带时间转写的补救方法
承诺兑现——是: 最终开头复核纳入了直接观察到的剪辑出错标题;问题切入优先于早期仅依据字幕的反常识草稿分类。
观看原始Short ↗09The Best AI Video Editor for YouTubers!Think Media · 痛点引导+
发布于2026年9月28日(UTC) · 61秒 · 32,255次公开播放
播放快照:2026年10月27日(UTC)
价值明确: 0–4秒 · 减少剪辑工作
首次有用交付: 9–15秒 · 将原始素材放入Gling
根据字幕与视频证据估计。
可复用结构: 剪辑困扰 → 上传原始素材 → 检查粗剪 → 导出
承诺兑现——是: 实际Gling示例完成了承诺的初剪流程。
观看原始Short ↗10Firefly 5 in Photoshop vs. Nano Banana: Fight!PiXimperfect · 直接承诺+
发布于2026年9月17日(UTC) · 40秒 · 23,688次公开播放
播放快照:2026年10月27日(UTC)
价值明确: 0–6秒 · 更好的选区式图像编辑
首次有用交付: 6–12秒 · 选区与生成填充移除提示词
根据字幕与视频证据估计。
可复用结构: 改进说法 → 一个选中对象 → 比较两个模型输出
承诺兑现——是: 完成并比较了一项具体移除任务;不推断通用模型排名。
观看原始Short ↗04 · 六种脚本结构
六种可复用脚本结构
把源于观察结构的六个模板用于你自己的任务、素材与证据。
如需更多构造的写作起点,可使用Kabo的视频钩子库。其中的示例是写作资源,与这个观察所得的100视频数据集分开。
- 01
一个结果,一个工具
你的开场下面介绍如何在[工具]中制作[具体输出]并修改[一个细节]。
需交付内容研究原始示例 ↗输入、输出及实际编辑。
- 02
从痛点到首个有用点击
你的开场还在手工做[熟悉任务]吗?这是我使用的工作流。
需交付内容研究原始示例 ↗进入工具的具体路径,而不只是推荐。
- 03
编号递进
你的开场用这三个步骤处理[范围明确的问题]。
需交付内容研究原始示例 ↗三个不同步骤,以及与范围相符的结尾。
- 04
范围明确的对比
你的开场[工具或方法]能解决[同一任务]吗?我将这样检查。
需交付内容研究原始示例 ↗一致输入、可检查输出及明确对比规则。
- 05
先失败,后解释
你的开场我请求了[具体输出]。这是不符之处。
需交付内容研究原始示例 ↗输入、失败输出及证据范围内的解释。
- 06
修改循环
你的开场首次尝试有[可见问题]。这条规则改变了它。
需交付内容研究原始示例 ↗修改前状态、改动及观众可评估的结果。
05 · 承诺兑现
正文兑现了开场承诺吗?
我们的编码将88条视频标为兑现开场承诺,12条标为部分兑现。没有标为否或不明确的视频。有效n=100;缺失判断=0。
视频数 · n=100 · 缺失=0
- 是
- 88
- 部分
- 12
- 否
- 0
计数刻度:0–100条视频
这项评估针对开场与正文的关系,不为产品主张、观众满意度或有效性认证。部分兑现常因承诺超出示例所能证实:完美记忆、普遍优越、完全替代,或片段结束后才交付结果。
写脚本时,把开场与结尾并排写下。承诺一次变化的教程应展示那次变化。测试需在既定条件下给出答案。宽泛主张需要更多证据或更窄措辞。
两条研究教程体现范围如何漂移。一条介绍五项提示改进,却在片段中只提供第一项;另一条开头声称有十二词提示词,结尾却停在来源上传指令,未给出该提示词。两条均标为部分。
06 · 应用发现
把发现用在下一条教程中
先选任务,再选措辞。找出让任务具体的输入、输出或失败,再决定口述句、第一幅画面与屏幕文字各自贡献什么。
把第一条可执行指令或有意义演示放到时间线上。检查其前面的铺垫是否必要。修改开场时让结尾保持可见,避免更刺激的一句话悄悄承诺另一条视频。
证据明确后,可用短视频钩子提示词探索措辞。发布后,用你自己的分析数据测试开场。
07 · 方法与样本
我们如何构建样本
我们筛查了60条频道记录,54条达到至少100,000订阅者门槛。最终样本包含30个频道的100条视频,每个频道一至五条。
视频须发布于2025年10月27日至2026年10月26日之间(Asia/Shanghai日期),时长15–90秒,通过英语口述或文字指令教学或演示可识别的AI工具任务。我们排除纯新闻、一般理论、非AI教程及没有具体演示的推广。仅有赞助并不排除有用教程。
符合条件账号的138页上传列表产生6,872条唯一记录。其中5,910条位于日期窗口内,2,009条同时满足时长规则。元数据筛查得到510个候选,其中214个有内容筛查决定。其余候选并未全部审查。
我们遵循记录中的账号池顺序,采用前30个有已识别、可访问合格素材的账号。按账号轮次填充样本,每轮从每个账号取下一条最新的已识别合格视频,直至100条。每账号上限为十条,实际最多五条。**没有最低播放量或按播放量排名。**上传页覆盖有限,因此这不是合格视频的穷尽目录。
公开元数据采集于2026年10月27日和29日。入选的三条视频公开播放量至少一百万,均来自Mrwhosetheboss。我们未用这一小子组比较钩子表现。
编码与时间
AI助手利用带时间字幕、完整视频分析及选取的提取画面,为每条视频分配一个主要钩子标签、评估承诺兑现并估计两个事件区间。时间区间向外取整到整秒。中位数边界取所有下端点和上端点的中位数,并非置信区间。字幕错误与解释判断会影响标签及时间。
下载100视频样本数据,其中包含视频ID、发布日期、播放快照、标签及证据备注。每条入选视频也在样本库中有附来源链接的解读。
08 · 局限与证据
本研究无法确立什么
这是成熟频道的探索性样本,并非创作者的随机或代表性样本。同一频道的视频可能共用开场风格。这些模式不能确立哪种钩子导致更好表现。
全部100条视频均接受完整视频分析。97条有可用口述字幕;三条没有配音,使用英语屏幕指令。详细视觉证据仅覆盖样本子集,时间区间仍是估计。未计算独立的评审者间一致性统计量。
有限上传页覆盖、元数据筛查及访问失败会影响哪些视频进入样本。来源链接、筛查决定及证据备注均保留,以便核查分析。
公开播放量无法揭示留存、分发来源或视频成功原因。YouTube在视频级Analytics提供观众留存报告。可把观察到的结构当作想法,用你自己的观众数据测试。