
我們分析了100支AI教學Shorts。創作者如何吸引觀眾?
透過繪畫編輯投影片的承諾。AI能否在聲音設計上勝過人的問題。讓七個模型執行同一任務的一罐糖豆。
創作者如何引出有用任務、開始示範並交付承諾結果。
我們研究了來自30個成熟頻道的100支英語AI教學及示範類YouTube Shorts,觀察創作者如何開啟一支有用的影片。在我們的編碼中,最常見的主要模式是直接承諾:100支影片中,有36支直接點明觀眾可以學會、製作或完成什麼。
這些模式描述樣本影片的結構。我們沒有測量觀眾續看率。
01 · 開場模式
這100支影片樣本中的開場模式
鉤子是開場時給觀眾繼續觀看理由的手法。我們按主要開場手法對每支影片分類,採用下列定義。類別重疊時以目的為先:為測試鋪陳的問題歸為實驗;圍繞觀眾困難的問題歸為痛點引導。
| 主要鉤子 | 含義 | 影片數 | 占比 |
|---|---|---|---|
| 直接承諾 | 點明觀眾將學會、製作或完成什麼。 | 36 | 36% |
| 痛點引導 | 從觀眾熟悉的問題開始。 | 17 | 17% |
| 其他 | 使用故事、類比、定義或立即給出指令。 | 15 | 15% |
| 結果先行 | 先展示完成的輸出或變化。 | 14 | 14% |
| 挑戰或實驗 | 設定測試、對比或帶限制的任務。 | 11 | 11% |
| 問題或好奇 | 打開需由影片解答的資訊缺口。 | 4 | 4% |
| 修正或警告 | 指出錯誤或應避免的做法。 | 3 | 3% |
| 反直覺 | 挑戰普遍持有的看法。 | 0 | 0% |
**有效樣本n=100;缺失主要分類=0。**沒有影片以反直覺作為主要標籤。
影片數 · n=100 · 缺失=0
- 直接承諾
- 36
- 痛點引導
- 17
- 其他
- 15
- 結果先行
- 14
- 挑戰或實驗
- 11
- 問題或好奇
- 4
- 修正或警告
- 3
- 反直覺
- 0
計數刻度:0–50支影片
這些標籤描述開場,而非其表現。僅僅延後答案,不足以把影片歸為好奇引導。
02 · 100支影片的時間分布
價值何時明確,有用內容又從何時開始
我們對全部100支影片的兩個時點編碼。價值明確指觀眾能夠識別所解決的問題或所提供的結果。首次實質交付指第一個可執行步驟、具體答案或有意義的任務示範。泛泛預告不計入。具體對比結果或示範輸入到輸出的變化,即使不是逐步點擊教學,也可以計入。
每支影片都有根據字幕與影片證據給出的估計時間區間。較寬區間代表證據較不精確;從零開始的區間表示事件可能已在開場出現。
價值明確時間的中位數落在0–6秒內;首次交付時間的中位數落在7.5–13秒內。我們分別取100個下端點和上端點的中位數來計算邊界。它們描述事件發生時間的不確定性,並非建議時限。
每項指標有效樣本n=100;缺失區間=0。未測量精確起始時刻。
估計時間區間 · n=100 · 未編碼=0
- 區間在10秒內結束
- 82
- 10秒時不確定
- 18
- 區間在10秒後開始
- 0
跨越區間包含10秒之前與之後的時刻。精確起始時刻仍是估計。
估計時間區間 · n=100 · 未編碼=0
- 區間在10秒內結束
- 29
- 10秒時不確定
- 41
- 區間在10秒後開始
- 30
跨越區間包含10秒之前與之後的時刻。精確起始時刻仍是估計。
到第十秒,82個價值明確區間及29個首次交付區間已經結束。另有18個價值區間和41個交付區間跨越十秒點:我們無法有把握地判斷事件在此之前還是之後發生。30個交付區間在十秒後開始。
具體案例體現了這項區別。Jeff Su在估計0–4秒的區間內介紹AI記憶結果,並在3–8秒區間開始講內建記憶設定。Andy Stapleton的學術提示片段較早傳達主題,但首條文件放置指令落在27–33秒區間。
可在樣本庫比較兩個時點,或下載完整時間表,其中包含事件描述及證據引用。
03 · 九個案例研究
九個值得研究的真實開場
1. 點明具體編輯,再實際完成
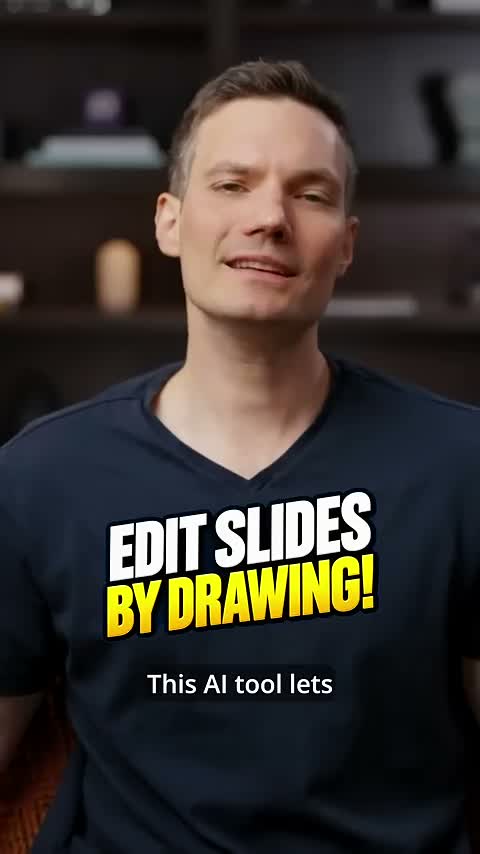
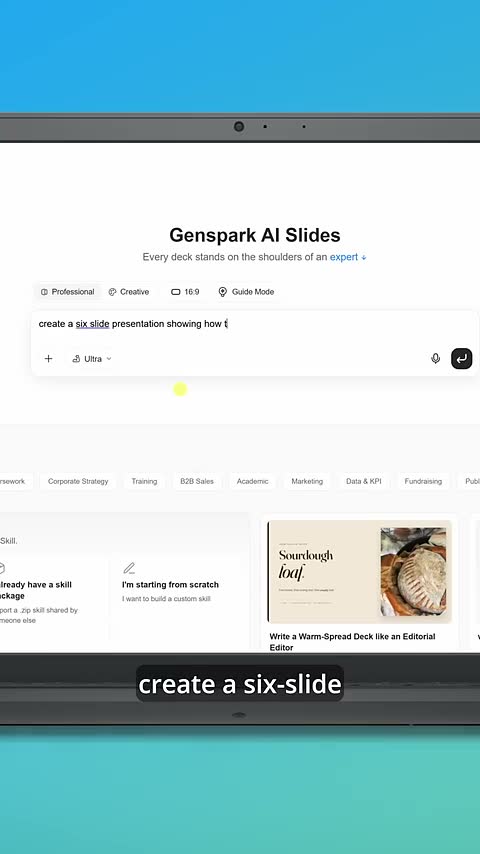
觀看原始ShortKevin Stratvert的投影片編輯教學把清楚的畫面標題與直接能力承諾配在一起。任務很具體:建立簡報,再透過在投影片上繪畫來修改它。
正文進入Genspark,請求六頁烘焙餅乾簡報,縮短副標題,並用箭頭移動影像。這些操作把開場連到觀眾能夠檢查的結果。可重用結構是一個結果、一個工具與一次可見修改,而非抽象地宣稱AI節省時間。
2. 把熟悉的負擔變成簡短路徑
觀看原始ShortAurelius Tjin的Gamma簡報教學以手工製作簡報的問題開始。開場標題已經點明期望結果。
片段隨後進入工具、提示詞、生成簡報及簡單修改。推薦優惠屬於內容的一部分,已記入研究表。可遷移到其他教學的是這個順序:熟悉的工作、具體替代方案、首個有用步驟、可檢查結果。
3. 讓編號承諾不超出證據
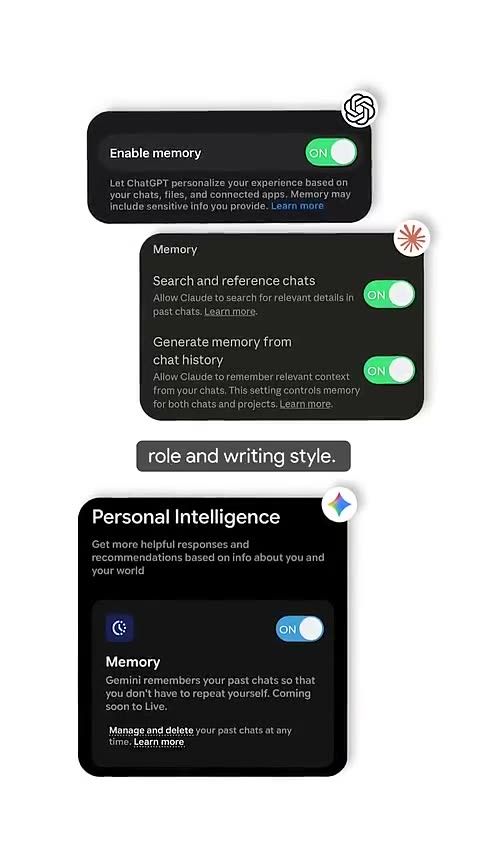
觀看原始ShortJeff Su的AI記憶教學圍繞三層組織正文:內建記憶、專案及自訂記憶系統。它提供清楚的遞進,而非鬆散技巧清單。
我們把交付標為部分,因為開場的完美記憶、此後無需修正等範圍超出三個範例所能證實。可用的寫作經驗是保留遞進,把承諾收窄到影片能示範的範圍。三步結構不需要無限保證。
4. 讓對比可聽見且範圍明確
觀看原始ShortCurious Refuge的AI與人類聲音設計測試提出正文確實能回應的問題。它採用同一場景,先播放AI版本與人類版本,再給出判斷。
我們將其編碼為挑戰,而非泛泛提問。對比任務提供了結構。判斷仍是創作者對這些範例的評價,並不能證明某種方法總能產生更好的聲音設計。
5. 給實驗一個真實答案
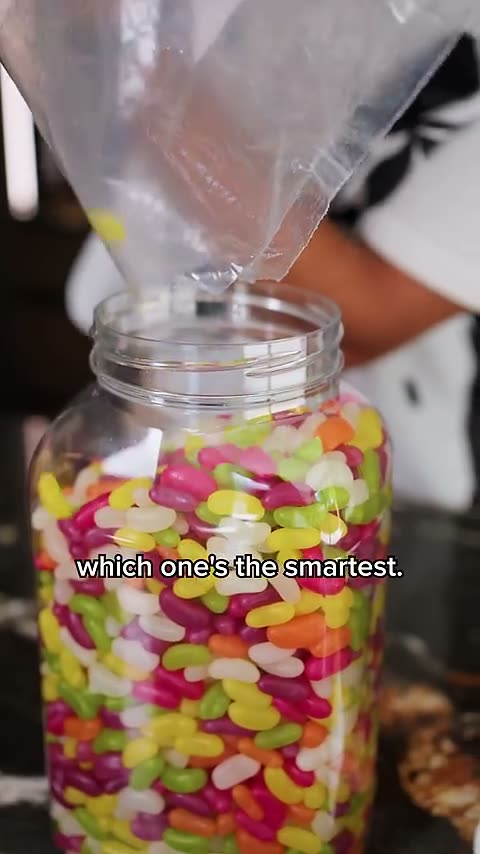
觀看原始Short在哪個AI最聰明?中,Mrwhosetheboss用一罐糖豆把模型對比任務變得可見。每個模型都需估數;最後清點數提供真實答案。
結尾回答了開頭設定的測試,但沒有確立普遍最聰明的模型。改編這個結構時,錄製前先決定輸入、評分規則與結尾。否則,對比可能變成沒有結論的一連串輸出。
6. 先展示具體失敗,再解釋
觀看原始ShortAI回答不了的問題先提出一項涉及左手寫字者的影像請求,再指出不符。雞蛋數量與鏡中倒影延續這個模式。
這是圍繞失敗的結果先行結構。具體提示詞與可檢查錯誤讓解釋有所針對。我們的編碼關注呈現與兌現承諾,不驗證影片對模型內部機制的簡化說法。
7. 用修改過程填充故事中段
觀看原始ShortNate Herk的Claude編輯示範描述迭代過程:看不清的字幕變成對比度規則,靜態素材變成動態要求,同步問題變成檢查項。
正文在工作流程中為每項改進交代原因:具體回饋成為持續使用的編輯規則。這為講最佳化的教學形成可重複結構。展示起初問題,說明改動,再展示作用。發現託管關鍵影格不一致後,我們對該來源作了交叉核對;有爭議的畫面未用作時間或視覺證據。
8. 讓畫面承擔教學
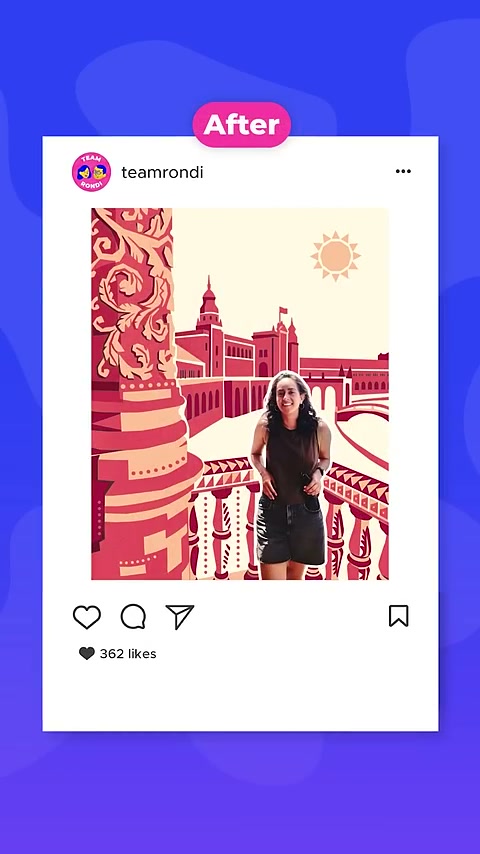
觀看原始ShortDesign with Canva的照片改風格示範沒有口述開場句。標題與照片變化引出任務,螢幕錄影再透過箭頭、提示詞與介面操作引導觀眾。
結尾在前後對比的社群模型中展示改風格構圖。這個結構不需要口播承諾也能理解:標題點明變化,畫面提供步驟,結尾回到變化。缺失的口述句按不存在記錄,而非從音樂轉寫重構。
9. 把研究缺口變成第一個行動
觀看原始ShortAndy Stapleton的Perplexity前言寫作流程從參考文獻不足的問題開始。它進入具體研究提示詞,展示所得草稿及參考文獻,再解釋如何把文獻用於引用流程。
他明確把輸出視為起點,而非直接照抄的文字。可遷移結構是具體缺口、工具操作、可檢查輸出與範圍明確的下一步。本研究不獨立驗證生成的參考文獻,也不把草稿當已完成的學術作品。
完整樣本 · 30個貢獻頻道探索全部100支影片解讀+
瀏覽每支入選影片。標籤描述開場與交付;公開觀看次數是背景,不是鉤子有效性的衡量。
查看全部30個貢獻頻道及樣本數
- Jeff Su ↗影片數:5
- Kevin Stratvert ↗影片數:5
- Futurepedia ↗影片數:5
- The AI Advantage ↗影片數:5
- Skill Leap AI ↗影片數:5
- Hayls World ↗影片數:1
- Matt Wolfe ↗影片數:5
- Justin Brown - Primal Video ↗影片數:5
- Think Media ↗影片數:2
- PiXimperfect ↗影片數:2
- Aurelius Tjin ↗影片數:5
- Beebom ↗影片數:2
- Website Learners ↗影片數:5
- Mrwhosetheboss ↗影片數:3
- Theoretically Media ↗影片數:2
- Curious Refuge ↗影片數:4
- Nate Herk | AI Automation ↗影片數:4
- Riley Brown ↗影片數:4
- Sam Beckman ↗影片數:1
- Trakin Tech English ↗影片數:4
- Creator Magic ↗影片數:2
- Tina Huang ↗影片數:4
- The Rundown AI ↗影片數:1
- Olivio Sarikas ↗影片數:1
- Andy Stapleton ↗影片數:4
- corbin ↗影片數:1
- Matthew Berman ↗影片數:4
- Design with Canva ↗影片數:4
- Ali Abdaal ↗影片數:4
- Sebastian Kamph ↗影片數:1
匹配影片:100支 · 顯示1–10
01Give your AI perfect memory in 3 stepsJeff Su · 直接承諾+
發布於2026年9月2日(UTC) · 64秒 · 17,610次公開觀看
觀看快照:2026年10月27日(UTC)
價值明確: 0–4秒 · AI記憶效果
首次有用交付: 3–8秒 · 在點名工具中啟用內建記憶
根據字幕與影片證據估計。
可重用結構: 承諾改善記憶 → 內建設定 → 專案 → 自訂記憶
承諾兌現——部分: 提供三個步驟,但不足以證明記憶完美或永遠不須糾正。
觀看原始Short ↗02This AI Lets You Edit Presentations by Drawing! 🤯Kevin Stratvert · 直接承諾+
發布於2026年10月26日(UTC) · 57秒 · 3,163次公開觀看
觀看快照:2026年10月27日(UTC)
價值明確: 0–5秒 · 建立並繪圖修改投影片
首次有用交付: 4–10秒 · 進入網站並選擇AI投影片;開頭結果預覽不是操作流程
根據字幕與影片證據估計。
可重用結構: 點明輸出與修改方式 → 產生簡報 → 繪圖修改 → 匯出
承諾兌現——是: 實際投影片產生與繪圖修改流程實現了所述能力。
觀看原始Short ↗03Claude video generator is a game changerFuturepedia · 直接承諾+
發布於2026年10月24日(UTC) · 75秒 · 3,564次公開觀看
觀看快照:2026年10月27日(UTC)
價值明確: 0–5秒 · Claude動畫及講解影片
首次有用交付: 8–12秒 · 實際星星動畫範例開始,不是開頭承諾
根據字幕與影片證據估計。
可重用結構: 點明新輸出 → 展示產生的講解影片 → 討論風格選擇
承諾兌現——是: 開頭介紹一種新輸出並承諾範例,主體提供了範例;並未承諾逐次點擊的完整製作教學。
觀看原始Short ↗04My Favorite Use Case for AI AgentsThe AI Advantage · 直接承諾+
發布於2026年10月23日(UTC) · 59秒 · 2,017次公開觀看
觀看快照:2026年10月27日(UTC)
價值明確: 5–9秒 · 透過代理預約
首次有用交付: 15–24秒 · 先將同事與代理放入Slack聊天,再要求時段
根據字幕與影片證據估計。
可重用結構: 點明喜愛任務 → Slack請求 → 日曆輸出 → 排程規則
承諾兌現——是: 展示了可辨識的預約流程。
觀看原始Short ↗05Gemini 4 Just Did Something WildSkill Leap AI · 結果先行+
發布於2026年10月23日(UTC) · 52秒 · 2,053次公開觀看
觀看快照:2026年10月27日(UTC)
價值明確: 0–6秒 · 漫遊產生的古羅馬
首次有用交付: 4–11秒 · 提示詞與可導航環境的遊覽
根據字幕與影片證據估計。
可重用結構: 展示產生世界 → 公開提示詞 → 瀏覽輸出 → 有限比較
承諾兌現——是: 提供可重現的任務描述與互動輸出。
觀看原始Short ↗06iOS 27 - NEW Photo ToolsHayls World · 挑戰或實驗+
發布於2026年6月11日(UTC) · 67秒 · 325,629次公開觀看
觀看快照:2026年10月27日(UTC)
價值明確: 0–5秒 · 測試照片編輯工具
首次有用交付: 9–14秒 · 在要移除的物件周圍畫圈
根據字幕與影片證據估計。
可重用結構: 測試新編輯工具 → 移除物件 → 擴展照片 → 改變視角 → 展示結果
承諾兌現——是: 實作範例完成了開頭設定的照片編輯測試;裝置可用性與技術實作未獨立核實。
觀看原始Short ↗07These ChatGPT Prompts Are Game-Changers!Matt Wolfe · 直接承諾+
發布於2026年10月23日(UTC) · 51秒 · 8,798次公開觀看
觀看快照:2026年10月27日(UTC)
價值明確: 0–4秒 · 三個代理提示詞
首次有用交付: 10–16秒 · 開始展示降價及退款追蹤提示詞
根據字幕與影片證據估計。
可重用結構: 承諾三種用途 → 提供三個具體代理提示詞
承諾兌現——是: 提供三個任務提示詞;本分析不對自主執行交易作背書。
觀看原始Short ↗08Bad AI Video Edits? Check Your Transcript FirstJustin Brown - Primal Video · 痛點引導+
發布於2026年9月25日(UTC) · 40秒 · 1,809次公開觀看
觀看快照:2026年10月27日(UTC)
價值明確: 0–4秒 · 轉寫錯誤導致AI剪輯出錯
首次有用交付: 3–8秒 · 以具體重複開場白範例解釋剪輯錯誤
根據字幕與影片證據估計。
可重用結構: 剪輯出錯問題 → 轉寫範例 → 附時間轉寫的補救方法
承諾兌現——是: 最終開頭複核納入直接觀察到的剪輯出錯標題;問題切入優先於早期僅依字幕的反常識草稿分類。
觀看原始Short ↗09The Best AI Video Editor for YouTubers!Think Media · 痛點引導+
發布於2026年9月28日(UTC) · 61秒 · 32,255次公開觀看
觀看快照:2026年10月27日(UTC)
價值明確: 0–4秒 · 減少剪輯工作
首次有用交付: 9–15秒 · 將原始素材放入Gling
根據字幕與影片證據估計。
可重用結構: 剪輯困擾 → 上傳原始素材 → 檢查粗剪 → 匯出
承諾兌現——是: 實際Gling範例完成了承諾的初剪流程。
觀看原始Short ↗10Firefly 5 in Photoshop vs. Nano Banana: Fight!PiXimperfect · 直接承諾+
發布於2026年9月17日(UTC) · 40秒 · 23,688次公開觀看
觀看快照:2026年10月27日(UTC)
價值明確: 0–6秒 · 更好的選區式影像編輯
首次有用交付: 6–12秒 · 選區與生成填補移除提示詞
根據字幕與影片證據估計。
可重用結構: 改進說法 → 一個選中物件 → 比較兩個模型輸出
承諾兌現——是: 完成並比較一項具體移除任務;不推斷通用模型排名。
觀看原始Short ↗04 · 六種腳本結構
六種可重用腳本結構
把源於觀察結構的六個範本用於你自己的任務、素材與證據。
如需更多構造的寫作起點,可使用Kabo的影片鉤子庫。其中的範例是寫作資源,與這個觀察所得的100影片資料集分開。
- 01
一個結果,一個工具
你的開場下面介紹如何在[工具]中製作[具體輸出]並修改[一個細節]。
需交付內容研究原始範例 ↗輸入、輸出及實際編輯。
- 02
從痛點到首個有用點擊
你的開場還在手工做[熟悉任務]嗎?這是我使用的工作流程。
需交付內容研究原始範例 ↗進入工具的具體路徑,而不只是推薦。
- 03
編號遞進
你的開場用這三個步驟處理[範圍明確的問題]。
需交付內容研究原始範例 ↗三個不同步驟,以及與範圍相符的結尾。
- 04
範圍明確的對比
你的開場[工具或方法]能解決[同一任務]嗎?我將這樣檢查。
需交付內容研究原始範例 ↗一致輸入、可檢查輸出及明確對比規則。
- 05
先失敗,後解釋
你的開場我請求了[具體輸出]。這是不符之處。
需交付內容研究原始範例 ↗輸入、失敗輸出及證據範圍內的解釋。
- 06
修改循環
你的開場首次嘗試有[可見問題]。這條規則改變了它。
需交付內容研究原始範例 ↗修改前狀態、改動及觀眾可評估的結果。
05 · 承諾兌現
正文兌現了開場承諾嗎?
我們的編碼將88支影片標為兌現開場承諾,12支標為部分兌現。沒有標為否或不明確的影片。有效n=100;缺失判斷=0。
影片數 · n=100 · 缺失=0
- 是
- 88
- 部分
- 12
- 否
- 0
計數刻度:0–100支影片
這項評估針對開場與正文的關係,不為產品主張、觀眾滿意度或有效性認證。部分兌現常因承諾超出範例所能證實:完美記憶、普遍優越、完全替代,或片段結束後才交付結果。
寫腳本時,把開場與結尾並排寫下。承諾一次變化的教學應展示那次變化。測試需在既定條件下給出答案。寬泛主張需要更多證據或更窄措辭。
兩支研究教學體現範圍如何漂移。一支介紹五項提示改進,卻在片段中只提供第一項;另一支開頭聲稱有十二詞提示詞,結尾卻停在來源上傳指令,未給出該提示詞。兩支均標為部分。
06 · 應用發現
把發現用在下一支教學中
先選任務,再選措辭。找出讓任務具體的輸入、輸出或失敗,再決定口述句、第一幅畫面與畫面文字各自貢獻什麼。
把第一條可執行指令或有意義示範放到時間軸上。檢查其前面的鋪陳是否必要。修改開場時讓結尾保持可見,避免更刺激的一句話悄悄承諾另一支影片。
證據明確後,可用短影音鉤子提示詞探索措辭。發布後,用你自己的分析資料測試開場。
07 · 方法與樣本
我們如何建立樣本
我們篩查了60筆頻道記錄,54筆達到至少100,000訂閱者門檻。最終樣本包含30個頻道的100支影片,每個頻道一至五支。
影片須發布於2025年10月27日至2026年10月26日之間(Asia/Shanghai日期),時長15–90秒,透過英語口述或文字指令教學或示範可識別的AI工具任務。我們排除純新聞、一般理論、非AI教學及沒有具體示範的推廣。僅有贊助並不排除有用教學。
符合條件帳號的138頁上傳清單產生6,872筆唯一記錄。其中5,910筆位於日期窗口內,2,009筆同時滿足時長規則。中繼資料篩查得到510個候選,其中214個有內容篩查決定。其餘候選並未全部審查。
我們遵循記錄中的帳號池順序,採用前30個有已識別、可存取合格素材的帳號。按帳號輪次填充樣本,每輪從每個帳號取下一支最新的已識別合格影片,直至100支。每帳號上限為十支,實際最多五支。**沒有最低觀看次數或按觀看次數排名。**上傳頁覆蓋有限,因此這不是合格影片的窮盡目錄。
公開中繼資料採集於2026年10月27日和29日。入選的三支影片公開觀看次數至少一百萬,均來自Mrwhosetheboss。我們未用這個小子組比較鉤子表現。
編碼與時間
AI助理利用帶時間字幕、完整影片分析及選取的擷取畫面,為每支影片分配一個主要鉤子標籤、評估承諾兌現並估計兩個事件區間。時間區間向外取整到整秒。中位數邊界取所有下端點和上端點的中位數,並非信賴區間。字幕錯誤與解釋判斷會影響標籤及時間。
下載100影片樣本資料,其中包含影片ID、發布日期、觀看快照、標籤及證據備註。每支入選影片也在樣本庫中有附來源連結的解讀。
08 · 局限與證據
本研究無法確立什麼
這是成熟頻道的探索性樣本,並非創作者的隨機或代表性樣本。同一頻道的影片可能共用開場風格。這些模式不能確立哪種鉤子導致更好表現。
全部100支影片均接受完整影片分析。97支有可用口述字幕;三支沒有配音,使用英語畫面指令。詳細視覺證據僅覆蓋樣本子集,時間區間仍是估計。未計算獨立的評審者間一致性統計量。
有限上傳頁覆蓋、中繼資料篩查及存取失敗會影響哪些影片進入樣本。來源連結、篩查決定及證據備註均保留,以便核查分析。
公開觀看次數無法揭示續看率、分發來源或影片成功原因。YouTube在影片級Analytics提供觀眾續看率報告。可把觀察到的結構當作想法,用你自己的觀眾資料測試。