
转写适合研究别人怎样解释一个想法。但如果摘要删掉谁说的、何时说的、以及有哪些不确定性,它就没那么有用。我们以公开历史讲座为例,由Codex处理本地笔记,Kabo提供可用转写证据。
Kabo,面向创作者研究的AI智能体,检索可用转写文本。历史说法进入旁白前,笔记会保留来源归属与不确定性。
选择客户端并确认连接
准备来源日志与核实问题
[ ] video-links.txt——公开来源及各自可能回答的问题。
[ ] research-question.md——需比较的讲解选择、历史说法或术语。
[ ] source-log.md——语言、返回时间范围、检索日期与状态。
[ ] verification-questions.md——需要独立一手证据的说法。
[ ] notebook/——注明归属的转述、来源笔记及编辑决定。
检查转写能力与当前输入schema
一位历史视频制作者使用支持文件的MCP客户端Codex,比较公开讲座怎样解释一项印刷技术的引入。他需要注明归属的笔记,而不是重建整篇讲稿或自动事实核查。
询问客户端哪些转写工具已就绪、需要什么输入。Kabo在可用时提供public_video_fetch_transcript。不要推断所有公开视频都有可用文字,或所有来源语言都会如预期返回。缺失文本应保留为研究缺口。
检查转写就绪情况与public_video_fetch_transcript的当前schema。针对[公开URL]检索可用文本,保留来源语言与返回时间范围。若请求返回job_id,请保留。不要把排队确认总结成仿佛已取得转写。
完成数据检索后再总结
若工具立即返回文本,将其与来源元数据一起保留;若返回job_id,使用get_research_data_job检查最终状态,再以read_research_data_artifacts读取列出的产物。排队确认不是转写。此路径不同于读取已保存视频分析的get_analysis_run。
在核实历史说法前,使用“讲者表示”。这一归属说明可防止研究笔记把听来合理的讲座转成我们无依据的旁白。
若仍需选择相关视频,YouTube研究流程可补充候选发现。
通过get_research_data_job完成数据任务,再只用read_research_data_artifacts读取该任务列出的object_refs。写简短且注明归属的笔记,附来源URL、语言及有依据的时间。区分讲者说法、独立核实事实与我们的解释。比较讲解时不要抹平分歧。不确定人名标为待听音频,建立verification-questions.md。
撰写保留归属的笔记
让Codex保存含简短转述、来源URL、语言与有依据时间范围的笔记。区分讲者的说法、自己独立核实的事实,以及编辑解释。不确定的人名或术语应保留以供对照音频检查,不要悄悄“纠正”。
日后可检查的一条笔记
针对印刷史视频,一条有用笔记应分开处理这些工作:
- 来源:附真实视频URL。
- 讲者说法:检索后加入简短转述。
- 时间范围:仅使用返回或人工核对的时间。
- 核实问题:是否有独立一手来源支持该日期?
- 视觉问题:示范展示了转写遗漏的什么?
- 编辑行动:写脚本前解决这些问题。
比较讲解,不抹平分歧
询问各讲座认同什么,以及哪些差异可能来自范围、术语或确有争议的说法。只有措辞精确性重要时才用短摘录。不要拼装成原讲座的替代副本,也不要把转述翻译成看似直接引语的文字。
带着核实计划结束笔记
若已获本地文件访问授权,在研究笔记旁创建questions-to-check.md。加入口头文本无法回答的视觉示范问题。历史说法成为旁白前需要合适的独立证据;检索转写不会替你完成核实。
转写中的技术名称看起来不可靠。保留不确定措辞,附来源链接,并增加音频或一手来源核对项,不要悄悄选择一个看似合理的术语。
根据已核实笔记撰写旁白
用Google Docs从已核实笔记发展脚本。让来源引用与说法清单一起保留,历史示范在视觉上重要时都应检查原视频。
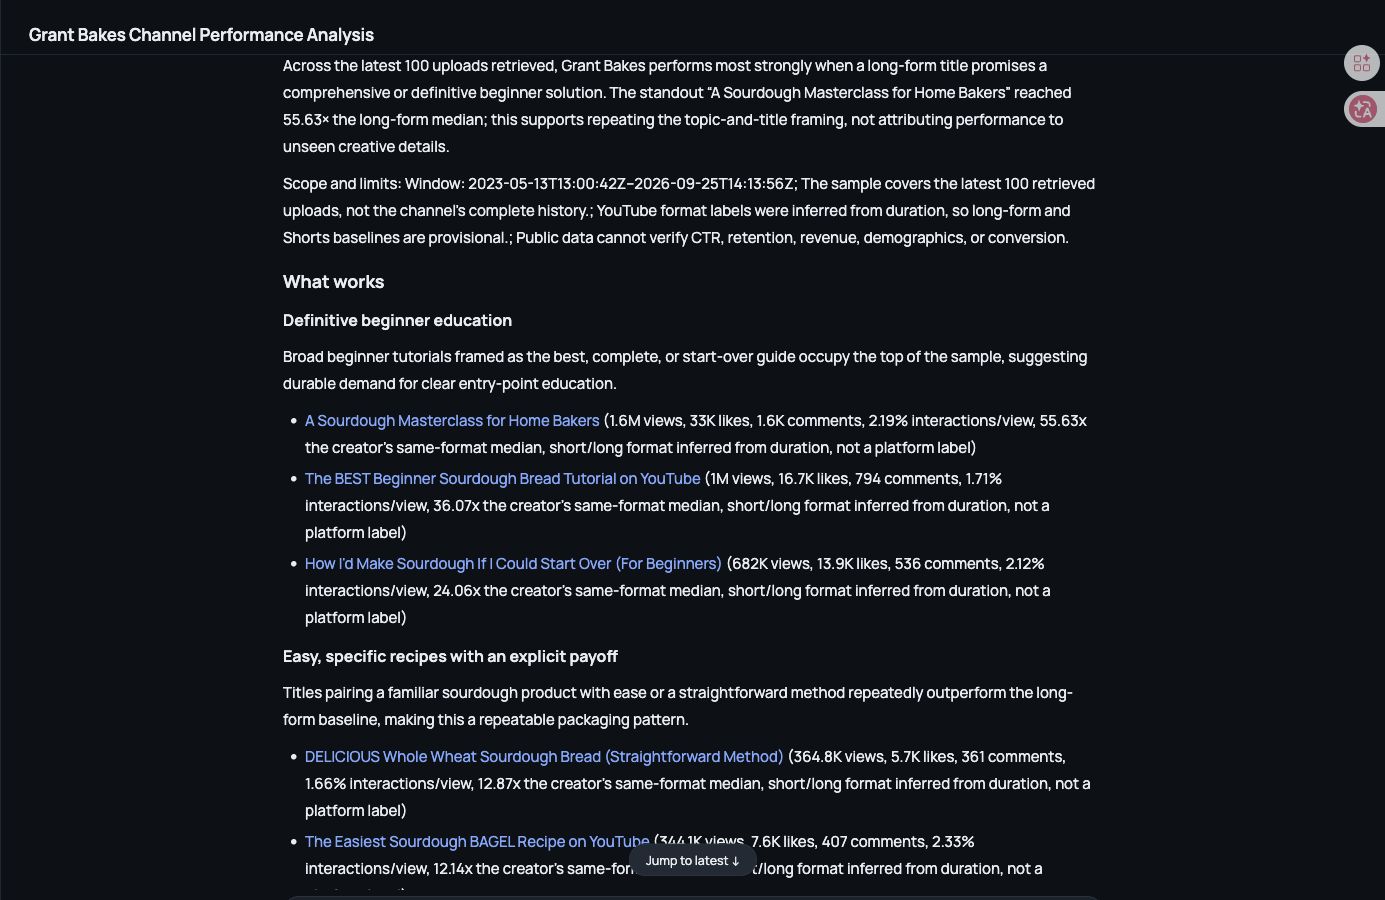
文中的完整示例用于说明方法。产品截图展示的是 Kabo 网页端已有的结果,并非本指南示例的实际执行记录。请使用自己的素材,以及您的任务实际返回的证据。